PDF テキスト抽出を無料でオンライン
コピーできないネイティブPDFやスキャンPDFから端末内OCRでクリーンな編集可能テキストを抽出。テキストをコピーするか.txtファイルでダウンロード、ページ数制限なし。
PDFをテキストに変換する方法
PDFを追加する
このページ上部のボックスにPDFをドラッグするか、クリックして選択してください。最大20件まで一度に追加できます。
ページが読み取られるのを待つ
実際のテキストがあるページはすぐに読み取られます。スキャンされたページは自動的に検出され、選択した言語でOCRにより読み取られます。切り替えるモードはありません。
コピーまたはダウンロード
お好みでテキストを編集し、コピーするか.txtファイルとして保存してください。複数のPDFがある場合は、1つの.txtファイルまたはZIPとしてまとめてダウンロードできます。
主な機能
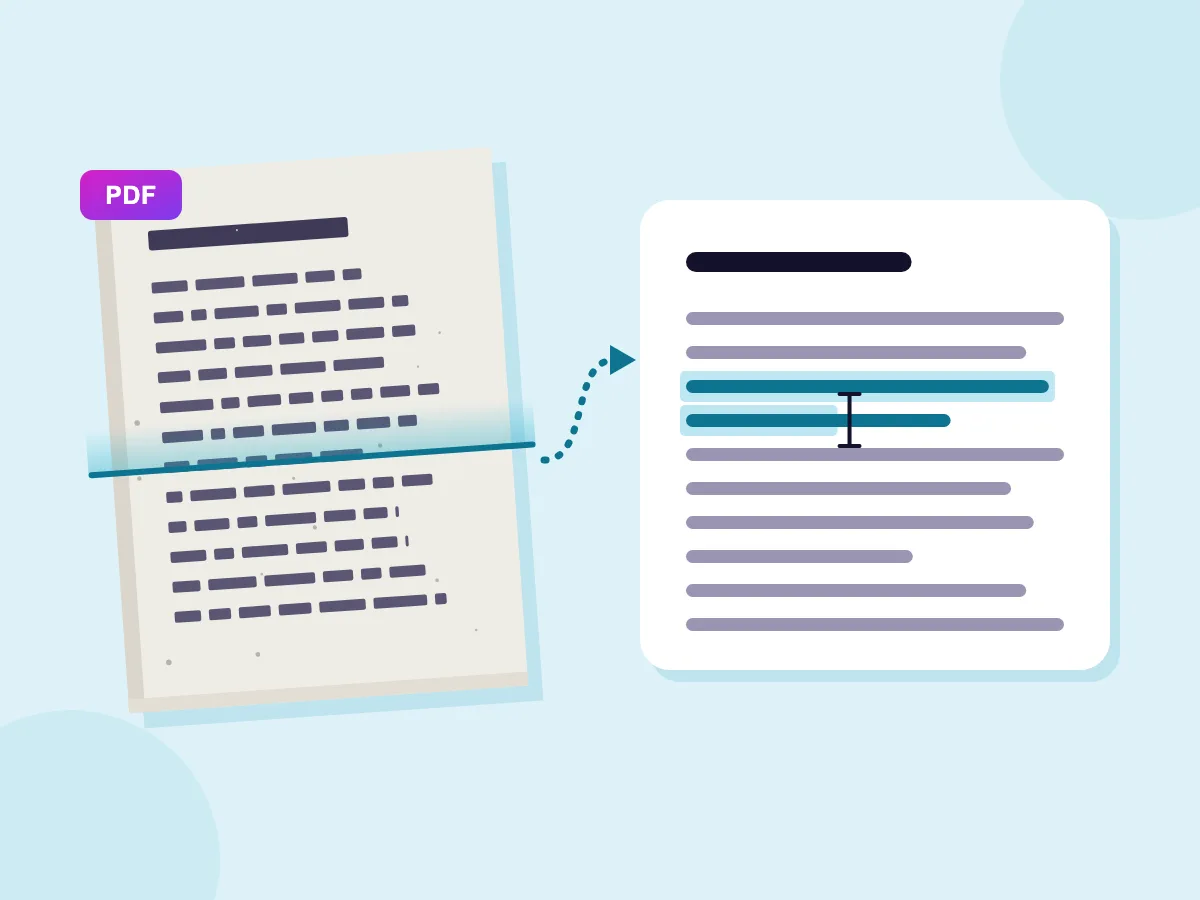
スキャンページも読み取り(OCR)
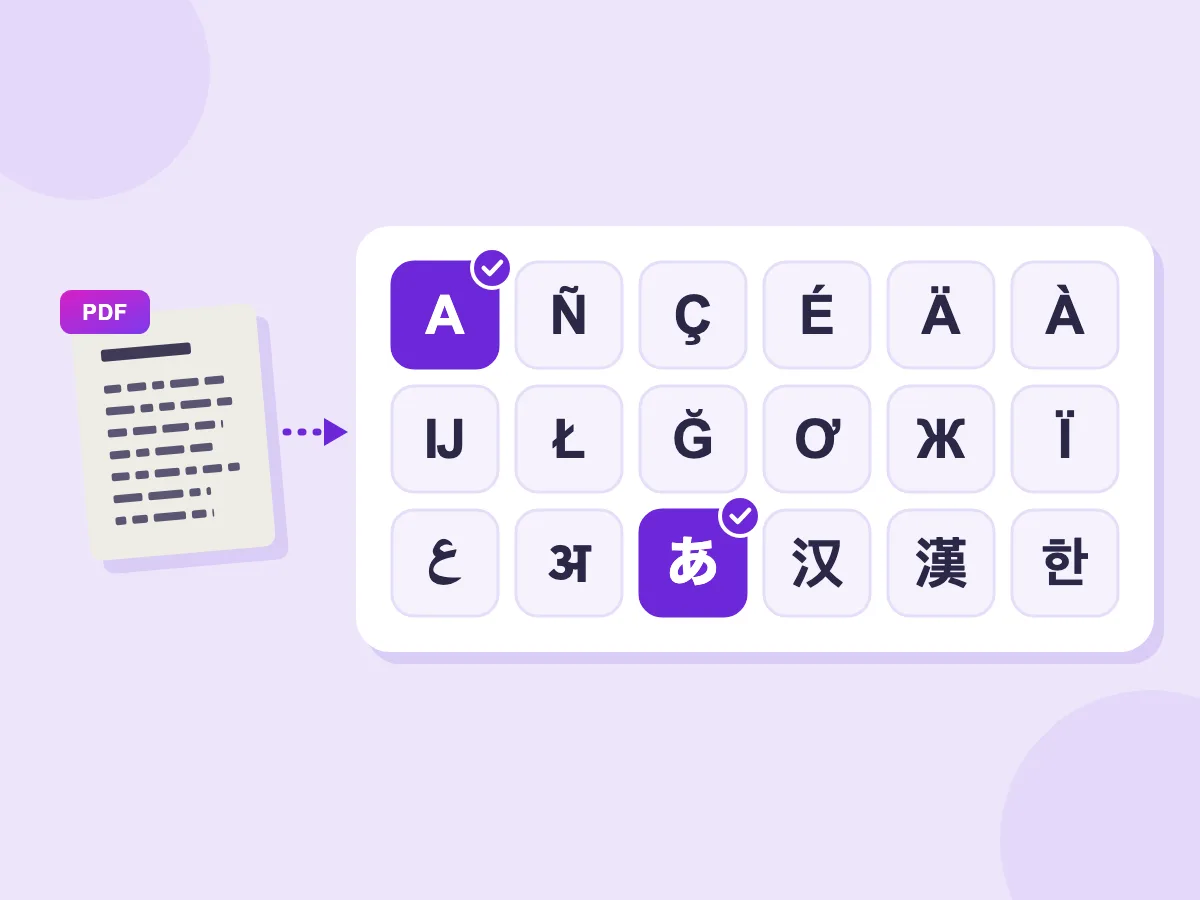
OCR対応18言語
- 整った段落
- PDFを最大20件まとめて処理
- コピーまたは.txtで保存
PDFテキスト抽出の活用シーン
仕事
- 契約書やスキャンした手紙から条項をコピーする
- PDFとして保存されたレポートやスライドのテキストを再利用する
- 請求書や銀行明細から詳細情報を取得する
- テキストをドキュメントや表計算アプリに貼り付けて編集する
学業・研究
- 論文を打ち直すことなく引用する
- スキャンした書籍のページを検索できるメモに変換する
- 講義スライドや配布資料からテキストを取り出す
- 複数のPDFから一度に引用を集める
日常のシーン
- PDFをAIチャットツールに貼り付けて要約や質問をする
- 選択できないPDFからテキストをコピーする
- テキストを翻訳ツールに貼り付ける
- マニュアルやフォーム、レシピをプレーンテキストファイルとして保存する
一部のPDFはテキストをコピーできないのはなぜ?
一部のPDFはテキストそのものではなく、テキストの画像を保持しています。スキャンしたページは単なる画像なので、選択やコピーができません。このツールは実際のテキストをOCRなしでPDFから直接読み取るため、高速かつ正確です。画像であるページに対してのみOCRを実行します。
スキャンしたPDFをOCRでテキストに変換
スキャンしたPDFは各ページが画像であるため、テキストをOCR(光学文字認識)で読み取る必要があります。このツールは各ページを個別にチェックし、スキャンされたページを自動的にOCRで読み取ります。
- 各ページは「テキスト」「OCR」「空白」としてマークされるため、どのページがスキャンされたかが分かります。
- テキストが四角や文字化けとしてコピーされるページも、スキャンとして扱われOCRで読み取られます。
- スキャンしたページは選択した言語で読み取られます。18言語から最大3言語まで同時に選択できます。
- あるページのテキストがおかしいと感じたら、そのページ番号をクリックして「OCRで読み取る」を選び、スキャンとして再度読み取ってください。
混在するPDFにも対応しています。タイプされたページとスキャンされたページは、ページ順に1つのテキストとしてまとめられます。
PDFではなく写真やスクリーンショットをお持ちですか?画像テキスト抽出でテキストを取得できます。
改行なしでPDFからテキストをコピーする
PDFからコピーしたテキストは、通常行末ごとに改行が入ります。「行を段落に結合」は折り返された文をつなぎ合わせ、ドキュメントやメール、AIチャットツールにきれいに貼り付けられるようにします。デフォルトでオンになっています。
このクリーンアップでは、PDFテキストを乱雑にするその他の要素も修正されます:
- 行末でハイフンで分割された単語は、1つの単語として結合されます。
- 見出し、リスト項目、表の行はそれぞれ独立した行のままになります。
- 「ヘッダー・フッター・ページ番号を削除」は、各ページで繰り返されるヘッダー、フッター、ページ番号を取り除きます。デフォルトでオンになっています。
- 「--- ページ3 ---」のようなページマーカーは、各ページの開始位置を示します。1つの連続したテキストにまとめたい場合はオフにしてください。
各オプションはPDFを読み直すことなく、すぐにテキストを更新します。「行を段落に結合」をオフにすると、PDF内のすべての改行がそのまま保持されます。
無料・非公開・無制限
このPDFテキスト抽出ツールは無料で、登録もアカウントも不要です。さらに次の特長があります:
- プライバシー保護。PDFはお使いの端末内で処理されます。スマートフォンやパソコン上で開いて読み取られ、ファイルがサーバーに送信されることはありません。
- ページ数制限も1日の制限もなし。各PDFは最大100MBまで、一度に最大20件まで追加できます。
- ロックされたファイルも安全に処理。パスワード保護されたPDFは、お使いの端末上で入力したパスワードを使って開かれ、パスワードは保存されません。
スキャンされたページを初めて読み取る際、OCRリーダーが一度だけダウンロードされます(英語の場合約4MB)。ブラウザに保存されるため、以降のスキャンはより高速に開始できます。実際のテキストのみのPDFにはこの処理は不要です。
PDFからテキストを抽出する最良の方法とは?
PDFがすでに保持しているテキストを読み取り、スキャンされたページにのみ適切な言語でOCRを使用します。これにより、タイプされたページは正確なまま、スキャンされたページもできるだけ正確に保たれます。このツールはページごとにその判断を自動で行います。
以下のコツで、よりきれいなテキストが得られます:
- 正しいOCR言語を選んでください。例えば、ドイツ語を英語として読み取るとウムラウトが失われます。
- 複数言語が混在するスキャンには、最大3言語まで選択してください。
- はっきりとした、まっすぐなスキャンを使用してください。かすれたページや傾いたページはミスが増えます。
- あるページが文字化けする場合は、そのページ番号をクリックして「OCRで読み取る」を選んでください。
- スキャンしたページの氏名、数字、メールアドレスは確認してください。最も誤読されやすい部分です。
PDFのOCRにはどれくらい時間がかかりますか?実際のテキストがあるページは、長いPDFでもほぼ瞬時に読み取られます。スキャンされたページは1ページあたり数秒かかり、進捗を確認したり、いつでも停止したりできます。
OCRは印刷されたテキスト向けに作られています。手書き文字や画質の悪いスキャンはミスが出やすくなります。雑誌やフォームのような複雑なレイアウトも順序が入れ替わることがあるため、使用前にテキストを確認してください。
よくある質問
スキャンページ、対応言語、制限、プライバシーについて
PDFを無料でテキストに変換するには?
このページ上部のボックスにPDFを追加すると、各ページが読み取られるにつれてテキストが表示されます。その後、コピーするか.txtファイルとしてダウンロードできます。無料で、登録も1日の制限もありません。
スキャンしたPDFからテキストを抽出できますか?
はい。実際のテキストがないページは自動的に検出され、選択した言語でOCRにより読み取られます。はっきりとした印刷物のスキャンほど正確なテキストが得られます。かすれたコピーや手書きはミスが増えるため、氏名や数字を確認してください。
PDFはサーバーにアップロードされますか?
いいえ。PDFはお使いの端末上で開かれ、読み取られ、ファイルとそのテキストは端末内に留まります。スキャンされたページを初めて読み取る際にOCR言語モデルをダウンロードしますが、PDFの内容は一切送信されません。
パスワード保護されたPDFからテキストを抽出できますか?
はい、パスワードを知っていれば可能です。求められたら入力すると、PDFがお使いの端末上で開かれます。このツールはパスワードの削除や解読は行わず、パスワードも保存・送信されません。
どの言語に対応していますか?
実際のテキストがあるページは、PDFに保存されている言語のまま読み取られます。スキャンされたページは、英語、スペイン語、フランス語、ドイツ語、中国語、日本語、韓国語、アラビア語、ヒンディー語、ロシア語を含む18言語でOCRにより読み取れます。複数言語が混在するテキストには最大3言語まで選択できます。
書式は保持されますか?
いいえ。結果はプレーンテキストのため、フォント、色、画像、正確なレイアウトは保持されません。ただし、段落、見出し、リスト項目、表の行はそれぞれ独立した行のまま保たれます。ページの見た目をそのまま保ちたい場合は、代わりにページを画像に変換してください。
テキストをTXTファイルとして保存できますか?
はい。「.txtをダウンロード」を選ぶと、元のPDF名を使ったUTF-8テキストファイルが保存され、アクセント記号や非ラテン文字も正しく表示されます。保存前にテキストを編集でき、編集内容がそのまま保存されます。
ページ数やファイルサイズに制限はありますか?
ページ数制限も1日の制限もありません。各PDFは最大100MBまで、一度に最大20件のPDFを追加できます。長いスキャンPDFは、スキャンされたページを1枚ずつ読み取るため時間がかかります。
複数のPDFを一度に変換できますか?
はい、一度に最大20件のPDFを処理できます。順番に読み取られます。その後、すべてのテキストをコピーするか、各PDFの見出し付きで1つの.txtファイルとしてダウンロードするか、PDFごとに1つのテキストファイルを含むZIPを取得できます。
スマートフォンでも使えますか?
はい。iPhoneやAndroidのスマートフォンのブラウザでこのページを開き、PDFを追加してテキストをコピーできます。インストールするアプリはありません。スキャンされたページはパソコンよりスマートフォンの方が時間がかかります。