Convertir un PDF en texte en ligne gratuitement
Extrayez un texte propre et modifiable depuis des PDF natifs ou scannés grâce à l'OCR sur votre appareil. Copiez le texte ou téléchargez-le en .txt, sans limite de pages.
Comment convertir un PDF en texte
Ajoutez vos PDF
Déposez vos PDF dans la zone en haut de cette page, ou cliquez pour les choisir. Vous pouvez en ajouter jusqu'à 20 à la fois.
Laissez les pages être lues
Les pages avec du texte réel sont lues immédiatement. Les pages scannées sont détectées automatiquement et lues avec l'OCR dans la langue de votre choix. Aucun mode à changer.
Copier ou télécharger
Modifiez le texte si vous le souhaitez, puis copiez-le ou enregistrez-le en fichier .txt. Avec plusieurs PDF, téléchargez tout en un seul fichier .txt ou en ZIP.
Fonctionnalités clés
Lit les pages scannées (OCR)
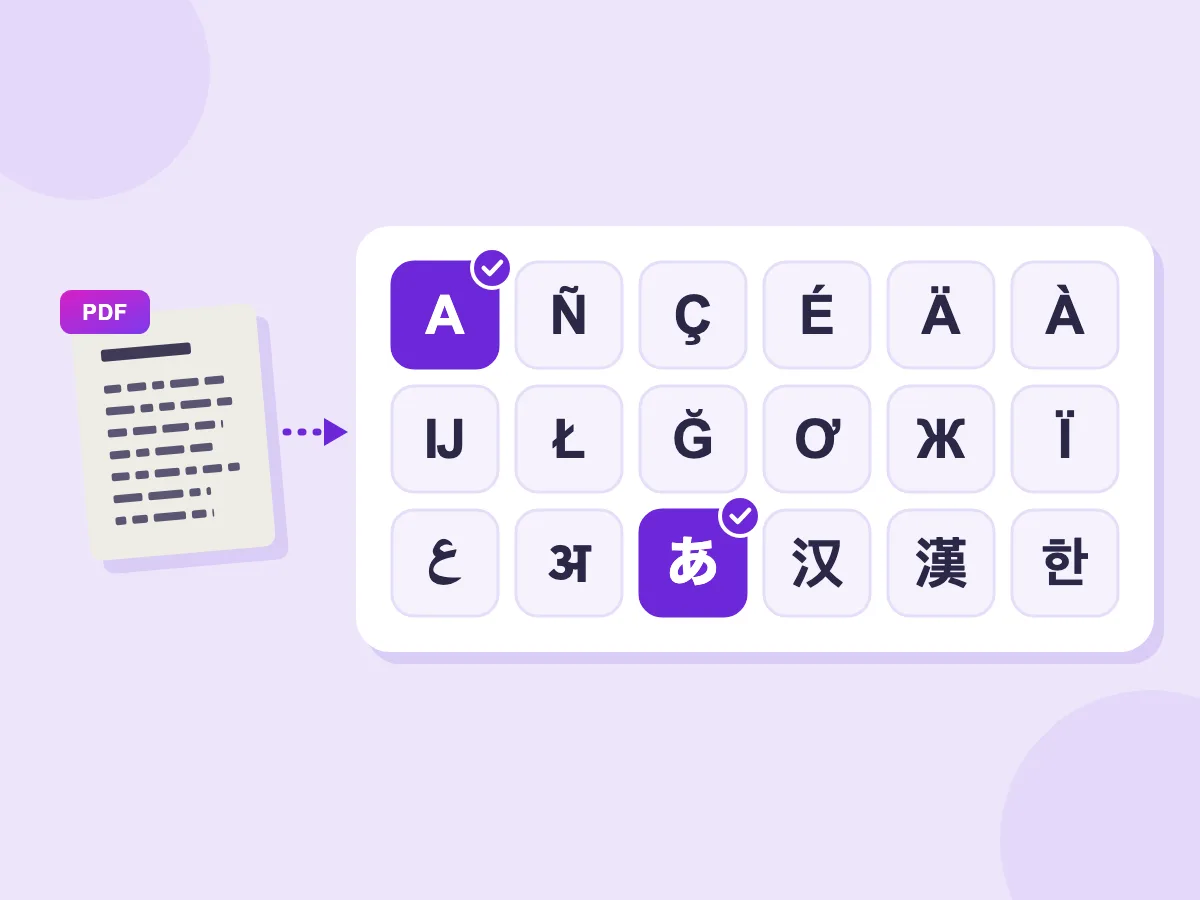
18 langues OCR
- Paragraphes nettoyés
- Jusqu'à 20 PDF à la fois
- Copier ou enregistrer en .txt
À quoi sert la conversion PDF en texte
Travail
- Copier des clauses d'un contrat ou d'une lettre scannée
- Réutiliser le texte d'un rapport ou d'une présentation enregistrée en PDF
- Récupérer les détails d'une facture ou d'un relevé bancaire
- Coller le texte dans un document ou un tableur pour le modifier
École et recherche
- Citer un article de recherche sans le retaper
- Transformer des pages de livre scannées en notes consultables
- Extraire le texte de diapositives de cours et de supports
- Rassembler des citations de plusieurs PDF en une seule opération
Au quotidien
- Coller un PDF dans un outil de chat IA pour le résumer ou poser des questions
- Copier le texte d'un PDF qui ne permet pas la sélection
- Coller le texte dans un traducteur
- Enregistrer un manuel, un formulaire ou une recette en fichier texte brut
Pourquoi ne puis-je pas copier le texte de certains PDF ?
Certains PDF contiennent une image du texte plutôt que le texte lui-même. Une page scannée n'est qu'une image, donc il n'y a rien à sélectionner ni à copier. Ce convertisseur lit le vrai texte directement depuis le PDF sans OCR, ce qui est rapide et exact. Il n'applique l'OCR qu'aux pages qui sont des images.
Convertir des PDF scannés en texte avec l'OCR
Un PDF scanné est une image de chaque page, donc son texte doit être lu par OCR (reconnaissance optique de caractères). Ce convertisseur vérifie chaque page individuellement et lit automatiquement les pages scannées avec l'OCR.
- Chaque page est marquée comme texte, OCR ou vide, afin que vous voyiez quelles pages ont été scannées.
- Les pages dont le texte se copie sous forme de cases ou de symboles étranges sont traitées comme des scans et lues avec l'OCR également.
- Les pages scannées sont lues dans la langue de votre choix. Choisissez parmi 18 langues, jusqu'à 3 à la fois.
- Si le texte d'une page semble incorrect, cliquez sur son numéro de page et choisissez Lire avec l'OCR pour la relire comme un scan.
Les PDF mixtes fonctionnent aussi. Les pages tapées et les pages scannées se retrouvent réunies en un seul texte, dans l'ordre des pages.
Vous avez une photo ou une capture d'écran au lieu d'un PDF ? Récupérez son texte avec le convertisseur d'image en texte.
Copier le texte d'un PDF sans sauts de ligne
Le texte copié d'un PDF se coupe généralement à la fin de chaque ligne. Fusionner les lignes en paragraphes reconstitue les phrases coupées, afin que le texte se colle proprement dans un document, un e-mail ou un outil de chat IA. C'est activé par défaut.
Ce nettoyage corrige aussi les autres problèmes qui rendent le texte PDF désordonné :
- Les mots coupés par un trait d'union en fin de ligne sont réunis en un seul mot.
- Les titres, éléments de liste et lignes de tableau restent sur leurs propres lignes.
- Supprimer les en-têtes, pieds de page et numéros de page retire les en-têtes, pieds de page et numéros de page répétés sur toutes les pages. C'est activé par défaut.
- Les repères de page comme --- Page 3 --- indiquent où commence chaque page. Désactivez-les pour obtenir un seul bloc de texte homogène.
Chaque option met à jour le texte instantanément, sans avoir besoin de relire le PDF. Désactivez Fusionner les lignes en paragraphes pour conserver chaque saut de ligne tel qu'il est dans le PDF.
Gratuit, privé et illimité
Ce convertisseur de PDF en texte est gratuit, sans inscription ni compte. Vous bénéficiez aussi de :
- Confidentialité. Votre PDF reste sur votre appareil. Il est ouvert et lu directement sur votre téléphone ou votre ordinateur, et le fichier n'est jamais envoyé à un serveur.
- Aucune limite de pages ni limite quotidienne. Chaque PDF peut aller jusqu'à 100 Mo, et vous pouvez en ajouter jusqu'à 20 à la fois.
- Fichiers verrouillés traités avec soin. Un PDF protégé par mot de passe est ouvert avec votre mot de passe sur votre appareil, et celui-ci n'est jamais enregistré.
La première fois qu'une page scannée est lue, le lecteur OCR se télécharge une fois (environ 4 Mo pour l'anglais). Il est enregistré dans votre navigateur, ce qui accélère les scans suivants. Les PDF ne contenant que du vrai texte n'en ont pas besoin.
Quelle est la meilleure façon d'extraire du texte d'un PDF ?
Lisez le texte que le PDF contient déjà, et n'utilisez l'OCR que sur les pages scannées, dans la bonne langue. Cela garantit l'exactitude des pages tapées et la plus grande précision possible pour les pages scannées. Cet outil fait ce choix pour vous, page par page.
Ces conseils vous donneront un texte plus propre :
- Choisissez la bonne langue OCR. L'allemand lu comme de l'anglais perd ses trémas, par exemple.
- Choisissez jusqu'à 3 langues pour les scans qui mélangent plusieurs langues.
- Utilisez un scan net et droit. Les pages floues ou de travers donnent plus d'erreurs.
- Si une page ressort illisible, cliquez sur son numéro de page et choisissez Lire avec l'OCR.
- Vérifiez les noms, chiffres et adresses e-mail sur les pages scannées. Ce sont les plus faciles à mal lire.
Combien de temps faut-il pour appliquer l'OCR à un PDF ? Les pages avec du vrai texte sont lues presque instantanément, même dans un long PDF. Chaque page scannée prend quelques secondes, et vous pouvez suivre la progression ou arrêter à tout moment.
L'OCR est conçu pour le texte imprimé. L'écriture manuscrite et les scans de mauvaise qualité génèrent souvent des erreurs. Les mises en page complexes comme les magazines et formulaires peuvent aussi ressortir dans un ordre confus, alors relisez le texte avant de l'utiliser.
Outils similaires
D'autres outils gratuits pour PDF et images
Questions fréquentes
Pages scannées, langues, limites et confidentialité
Comment convertir un PDF en texte gratuitement ?
Ajoutez votre PDF dans la zone en haut de cette page, et le texte apparaît au fur et à mesure que chaque page est lue. Puis copiez-le ou téléchargez-le en fichier .txt. C'est gratuit, sans inscription et sans limite quotidienne.
Puis-je extraire le texte d'un PDF scanné ?
Oui. Les pages sans vrai texte sont détectées automatiquement et lues avec l'OCR, dans la langue de votre choix. Les scans nets et imprimés donnent le texte le plus précis. Les copies floues et l'écriture manuscrite entraînent plus d'erreurs, donc vérifiez les noms et les chiffres.
Mon PDF est-il envoyé sur un serveur ?
Non. Votre PDF est ouvert et lu sur votre propre appareil, et le fichier ainsi que son texte y restent. L'outil télécharge un modèle de langue OCR la première fois qu'il lit une page scannée, mais rien de votre PDF n'est envoyé.
Puis-je extraire le texte d'un PDF protégé par mot de passe ?
Oui, si vous connaissez le mot de passe. Saisissez-le lorsqu'on vous le demande, et le PDF s'ouvre sur votre appareil. L'outil ne supprime ni ne pirate les mots de passe, et votre mot de passe n'est ni enregistré ni envoyé nulle part.
Quelles langues peut-il lire ?
Les pages avec du vrai texte sont lues dans la langue enregistrée dans le PDF. Les pages scannées sont lues avec l'OCR dans 18 langues, dont l'anglais, l'espagnol, le français, l'allemand, le chinois, le japonais, le coréen, l'arabe, l'hindi et le russe. Choisissez jusqu'à 3 langues à la fois pour du texte mixte.
La mise en forme sera-t-elle conservée ?
Non. Le résultat est du texte brut, donc les polices, couleurs, images et la mise en page exacte ne sont pas conservées. Les paragraphes, titres, éléments de liste et lignes de tableau restent bien sur leurs propres lignes. Pour garder les pages exactement identiques, transformez-les en images à la place.
Puis-je enregistrer le texte en fichier TXT ?
Oui. Télécharger en .txt enregistre un fichier texte UTF-8 nommé d'après votre PDF, afin que les accents et lettres non latines s'affichent correctement. Vous pouvez modifier le texte au préalable ; ce sont vos modifications qui seront enregistrées.
Y a-t-il une limite de pages ou de taille de fichier ?
Il n'y a aucune limite de pages ni limite quotidienne. Chaque PDF peut aller jusqu'à 100 Mo, et vous pouvez ajouter jusqu'à 20 PDF à la fois. Les longs PDF scannés prennent plus de temps, car chaque page scannée est lue une par une.
Puis-je convertir plusieurs PDF à la fois ?
Oui, jusqu'à 20 PDF à la fois. Ils sont lus les uns après les autres. Ensuite, copiez tout le texte, téléchargez-le en un seul fichier .txt avec un titre pour chaque PDF, ou obtenez un ZIP avec un fichier texte par PDF.
Fonctionne-t-il sur téléphone ?
Oui. Ouvrez cette page dans le navigateur de votre téléphone, iPhone ou Android, ajoutez un PDF, et copiez le texte. Aucune application à installer. Les pages scannées prennent plus de temps sur téléphone que sur ordinateur.