PDF in Text umwandeln, kostenlos online
Sauberen, bearbeitbaren Text aus nativen und gescannten PDF-Dateien extrahieren – mit OCR direkt im Gerät. Text kopieren oder als .txt-Datei herunterladen, ohne Seitenlimit.
So wandeln Sie ein PDF in Text um
PDFs hinzufügen
Ziehen Sie Ihre PDFs in das Feld oben auf dieser Seite, oder klicken Sie, um sie auszuwählen. Sie können bis zu 20 auf einmal hinzufügen.
Seiten werden gelesen
Seiten mit echtem Text werden sofort gelesen. Gescannte Seiten werden automatisch erkannt und mit OCR in der gewählten Sprache gelesen. Ein Moduswechsel ist nicht nötig.
Kopieren oder herunterladen
Bearbeiten Sie den Text bei Bedarf, dann kopieren oder speichern Sie ihn als .txt-Datei. Bei mehreren PDFs können Sie alles als eine .txt-Datei oder als ZIP herunterladen.
Hauptfunktionen
Liest gescannte Seiten (OCR)
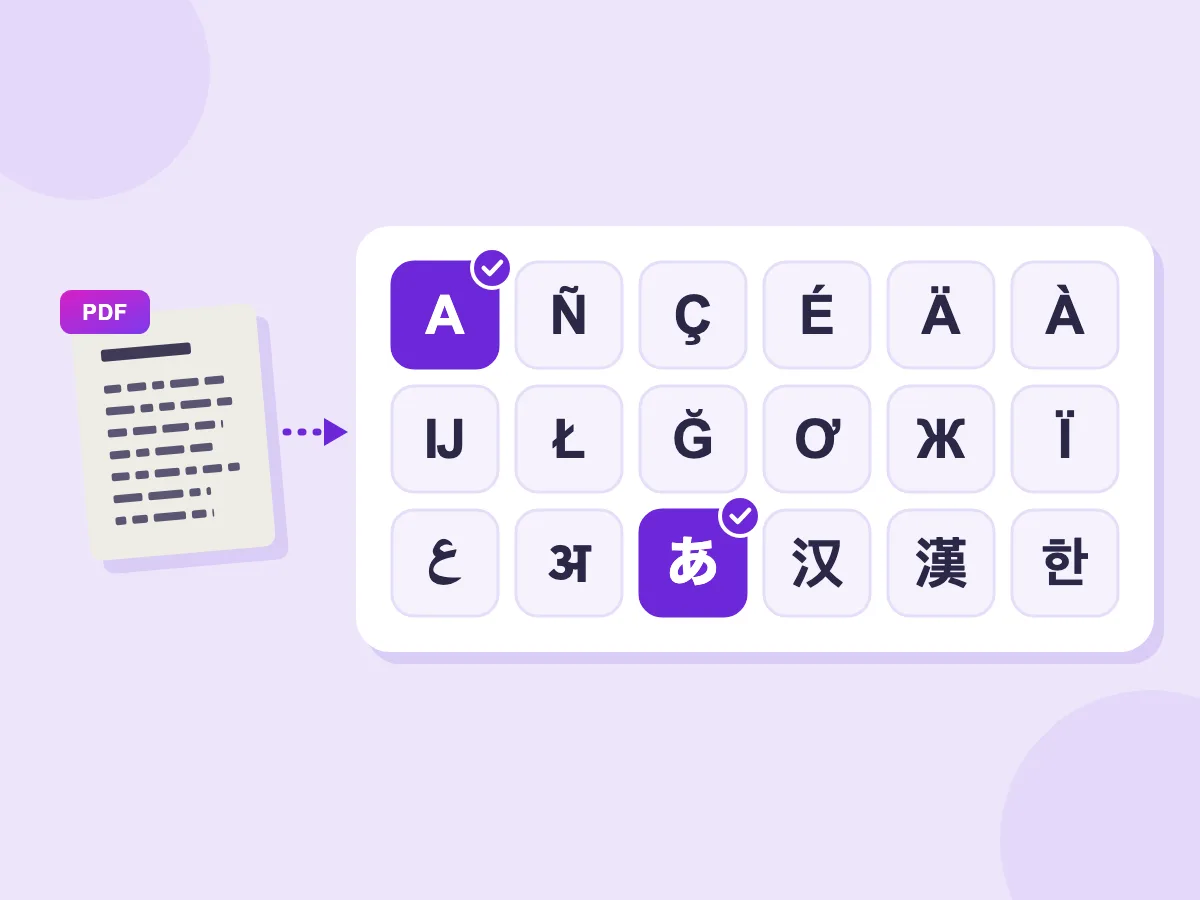
18 OCR-Sprachen
- Saubere Absätze
- Bis zu 20 PDFs gleichzeitig
- Kopieren oder als .txt speichern
Wofür Menschen PDF-zu-Text nutzen
Beruf
- Klauseln aus einem Vertrag oder gescannten Brief kopieren
- Text aus einem als PDF gespeicherten Bericht oder einer Präsentation weiterverwenden
- Angaben aus einer Rechnung oder einem Kontoauszug übernehmen
- Text zum Bearbeiten in eine Dokumenten- oder Tabellenkalkulations-App einfügen
Schule und Forschung
- Ein Forschungspapier zitieren, ohne es abzutippen
- Gescannte Buchseiten in durchsuchbare Notizen verwandeln
- Text aus Vorlesungsfolien und Handouts extrahieren
- Zitate aus mehreren PDFs auf einmal sammeln
Alltag
- Ein PDF in KI-Chat-Tools einfügen, um es zusammenzufassen oder Fragen dazu zu stellen
- Text aus einem PDF kopieren, das die Markierung nicht zulässt
- Text in einen Übersetzer einfügen
- Eine Anleitung, ein Formular oder ein Rezept als reine Textdatei speichern
Warum kann ich aus manchen PDFs keinen Text kopieren?
Manche PDFs enthalten ein Bild des Textes anstelle des Textes selbst. Eine gescannte Seite ist nur ein Bild, es gibt also nichts zum Markieren oder Kopieren. Dieser Konverter liest echten Text direkt aus dem PDF ohne OCR – das ist schnell und exakt. OCR kommt nur bei den Seiten zum Einsatz, die als Bild vorliegen.
Gescannte PDFs mit OCR in Text umwandeln
Ein gescanntes PDF ist ein Bild jeder Seite, daher muss der Text mit OCR (optischer Zeichenerkennung) gelesen werden. Dieser Konverter prüft jede Seite einzeln und liest die gescannten Seiten automatisch mit OCR.
- Jede Seite wird als Text, OCR oder leer markiert, sodass Sie sehen, welche Seiten gescannt wurden.
- Seiten, deren Text als Kästchen oder seltsame Symbole kopiert wird, gelten ebenfalls als Scans und werden mit OCR gelesen.
- Gescannte Seiten werden in der von Ihnen gewählten Sprache gelesen. Wählen Sie aus 18 Sprachen, bis zu 3 gleichzeitig.
- Wirkt der Text einer Seite fehlerhaft, klicken Sie auf die Seitenzahl und wählen Sie „Mit OCR lesen", um sie erneut als Scan zu lesen.
Auch gemischte PDFs funktionieren. Getippte und gescannte Seiten werden gemeinsam als ein Text in der richtigen Seitenreihenfolge zusammengeführt.
Haben Sie ein Foto oder einen Screenshot statt eines PDFs? Holen Sie sich den Text mit dem Bild-zu-Text-Konverter.
Text aus einem PDF ohne Zeilenumbrüche kopieren
Aus einem PDF kopierter Text bricht meist am Ende jeder Zeile um. „Zeilen zu Absätzen zusammenführen" fügt umgebrochene Sätze wieder zusammen, sodass der Text sauber in ein Dokument, eine E-Mail oder KI-Chat-Tools eingefügt werden kann. Diese Option ist standardmäßig aktiv.
Die Bereinigung behebt auch andere Ursachen für unsauberen PDF-Text:
- Wörter, die mit einem Bindestrich am Zeilenende getrennt sind, werden wieder zu einem Wort zusammengefügt.
- Überschriften, Listeneinträge und Tabellenzeilen bleiben in eigenen Zeilen.
- „Kopf-, Fußzeilen und Seitenzahlen entfernen" lässt wiederkehrende Kopf- und Fußzeilen sowie Seitenzahlen weg, die sich über die Seiten hinweg wiederholen. Diese Option ist standardmäßig aktiv.
- Seitenmarkierungen wie --- Seite 3 --- zeigen an, wo jede Seite beginnt. Deaktivieren Sie sie für einen zusammenhängenden Textblock.
Jede Option aktualisiert den Text sofort, ohne dass das PDF erneut gelesen werden muss. Deaktivieren Sie „Zeilen zu Absätzen zusammenführen", um jeden Zeilenumbruch wie im PDF zu erhalten.
Kostenlos, privat und unbegrenzt
Dieser PDF-zu-Text-Konverter ist kostenlos, ohne Anmeldung und ohne Konto. Zusätzlich erhalten Sie:
- Privatsphäre. Ihr PDF bleibt auf Ihrem Gerät. Es wird direkt auf Ihrem Smartphone oder Computer geöffnet und gelesen, die Datei wird nie an einen Server gesendet.
- Kein Seiten- und kein Tageslimit. Jedes PDF kann bis zu 100 MB groß sein, und Sie können bis zu 20 auf einmal hinzufügen.
- Geschützte Dateien werden sorgfältig behandelt. Ein passwortgeschütztes PDF wird mit Ihrem Passwort auf Ihrem Gerät geöffnet, das Passwort wird nicht gespeichert.
Beim ersten Lesen einer gescannten Seite lädt die OCR-Engine einmalig herunter (etwa 4 MB bei Englisch). Sie wird in Ihrem Browser gespeichert, sodass spätere Scans schneller starten. PDFs mit ausschließlich echtem Text benötigen sie nicht.
Wie extrahiert man am besten Text aus einem PDF?
Lesen Sie den Text, den das PDF bereits enthält, und setzen Sie OCR nur bei gescannten Seiten in der richtigen Sprache ein. So bleiben getippte Seiten exakt und gescannte Seiten so genau wie möglich. Dieses Tool trifft diese Entscheidung für Sie, Seite für Seite.
Diese Tipps sorgen für saubereren Text:
- Wählen Sie die richtige OCR-Sprache. Deutscher Text, der als Englisch gelesen wird, verliert zum Beispiel seine Umlaute.
- Wählen Sie bis zu 3 Sprachen für Scans mit gemischten Sprachen.
- Verwenden Sie einen klaren, geraden Scan. Blasse oder schiefe Seiten führen zu mehr Fehlern.
- Kommt eine Seite fehlerhaft heraus, klicken Sie auf die Seitenzahl und wählen Sie „Mit OCR lesen".
- Prüfen Sie Namen, Zahlen und E-Mail-Adressen auf gescannten Seiten. Sie werden am leichtesten falsch erkannt.
Wie lange dauert OCR bei einem PDF? Seiten mit echtem Text werden fast sofort gelesen, selbst bei langen PDFs. Jede gescannte Seite braucht wenige Sekunden, und Sie können den Fortschritt jederzeit verfolgen oder abbrechen.
OCR ist für gedruckten Text gemacht. Handschrift und schlechte Scans führen oft zu Fehlern. Komplexe Layouts wie Zeitschriften und Formulare können auch in falscher Reihenfolge herauskommen, lesen Sie den Text also vor der Nutzung durch.
Verwandte Tools
Weitere kostenlose Tools für PDFs und Bilder
Häufig gestellte Fragen
Gescannte Seiten, Sprachen, Limits und Datenschutz
Wie wandle ich ein PDF kostenlos in Text um?
Fügen Sie Ihr PDF in das Feld oben auf dieser Seite ein, und der Text erscheint, während jede Seite gelesen wird. Kopieren oder laden Sie ihn dann als .txt-Datei herunter. Es ist kostenlos, ohne Anmeldung und ohne Tageslimit.
Kann ich Text aus einem gescannten PDF extrahieren?
Ja. Seiten ohne echten Text werden automatisch erkannt und mit OCR in der gewählten Sprache gelesen. Klare, gedruckte Scans liefern den genauesten Text. Blasse Kopien und Handschrift verursachen mehr Fehler, prüfen Sie also Namen und Zahlen.
Wird mein PDF auf einen Server hochgeladen?
Nein. Ihr PDF wird auf Ihrem eigenen Gerät geöffnet und gelesen, die Datei und ihr Text bleiben dort. Das Tool lädt beim ersten Lesen einer gescannten Seite ein OCR-Sprachmodell herunter, aber nichts aus Ihrem PDF wird gesendet.
Kann ich Text aus einem passwortgeschützten PDF extrahieren?
Ja, wenn Sie das Passwort kennen. Geben Sie es bei Aufforderung ein, das PDF wird auf Ihrem Gerät geöffnet. Das Tool entfernt oder knackt keine Passwörter, und Ihr Passwort wird nicht gespeichert oder gesendet.
Welche Sprachen kann es lesen?
Seiten mit echtem Text werden in der im PDF gespeicherten Sprache gelesen. Gescannte Seiten werden mit OCR in 18 Sprachen gelesen, darunter Englisch, Spanisch, Französisch, Deutsch, Chinesisch, Japanisch, Koreanisch, Arabisch, Hindi und Russisch. Wählen Sie bis zu 3 gleichzeitig für gemischten Text.
Bleibt die Formatierung erhalten?
Nein. Das Ergebnis ist reiner Text, Schriftarten, Farben, Bilder und das exakte Layout bleiben nicht erhalten. Absätze, Überschriften, Listeneinträge und Tabellenzeilen bleiben jedoch in eigenen Zeilen. Um das Aussehen der Seiten exakt zu erhalten, wandeln Sie die Seiten stattdessen in Bilder um.
Kann ich den Text als TXT-Datei speichern?
Ja. „TXT herunterladen" speichert eine UTF-8-Textdatei, die nach Ihrem PDF benannt ist, sodass Akzente und nicht-lateinische Buchstaben korrekt angezeigt werden. Sie können den Text vorher bearbeiten; gespeichert wird Ihre bearbeitete Version.
Gibt es ein Seiten- oder Dateigrößenlimit?
Es gibt kein Seiten- und kein Tageslimit. Jedes PDF kann bis zu 100 MB groß sein, und Sie können bis zu 20 PDFs auf einmal hinzufügen. Lange gescannte PDFs dauern länger, da jede gescannte Seite einzeln gelesen wird.
Kann ich mehrere PDFs auf einmal umwandeln?
Ja, bis zu 20 PDFs gleichzeitig. Sie werden nacheinander gelesen. Kopieren Sie dann den gesamten Text, laden Sie ihn als eine .txt-Datei mit einer Überschrift für jedes PDF herunter, oder erhalten Sie ein ZIP mit einer Textdatei pro PDF.
Funktioniert es auf dem Smartphone?
Ja. Öffnen Sie diese Seite im Browser Ihres iPhones oder Android-Geräts, fügen Sie ein PDF hinzu und kopieren Sie den Text. Es ist keine App zu installieren. Gescannte Seiten dauern auf dem Smartphone länger als auf einem Computer.