免费在线PDF转文字
通过本地OCR技术,从原生或扫描版PDF文件中提取干净、可编辑的文字。可直接复制文字或下载为.txt文件,无页数限制。
如何将PDF转换为文字
添加PDF文件
将PDF拖放到本页顶部的框中,或点击选择文件。最多可同时添加20个文件。
自动识别页面内容
包含真实文字的页面会立即被读取。扫描页面会自动被检测出来,并使用你选择的语言进行OCR识别。无需手动切换模式。
复制或下载
可以先编辑文字,然后复制或保存为.txt文件。处理多个PDF时,可将全部内容下载为一个.txt文件或打包成ZIP。
核心功能
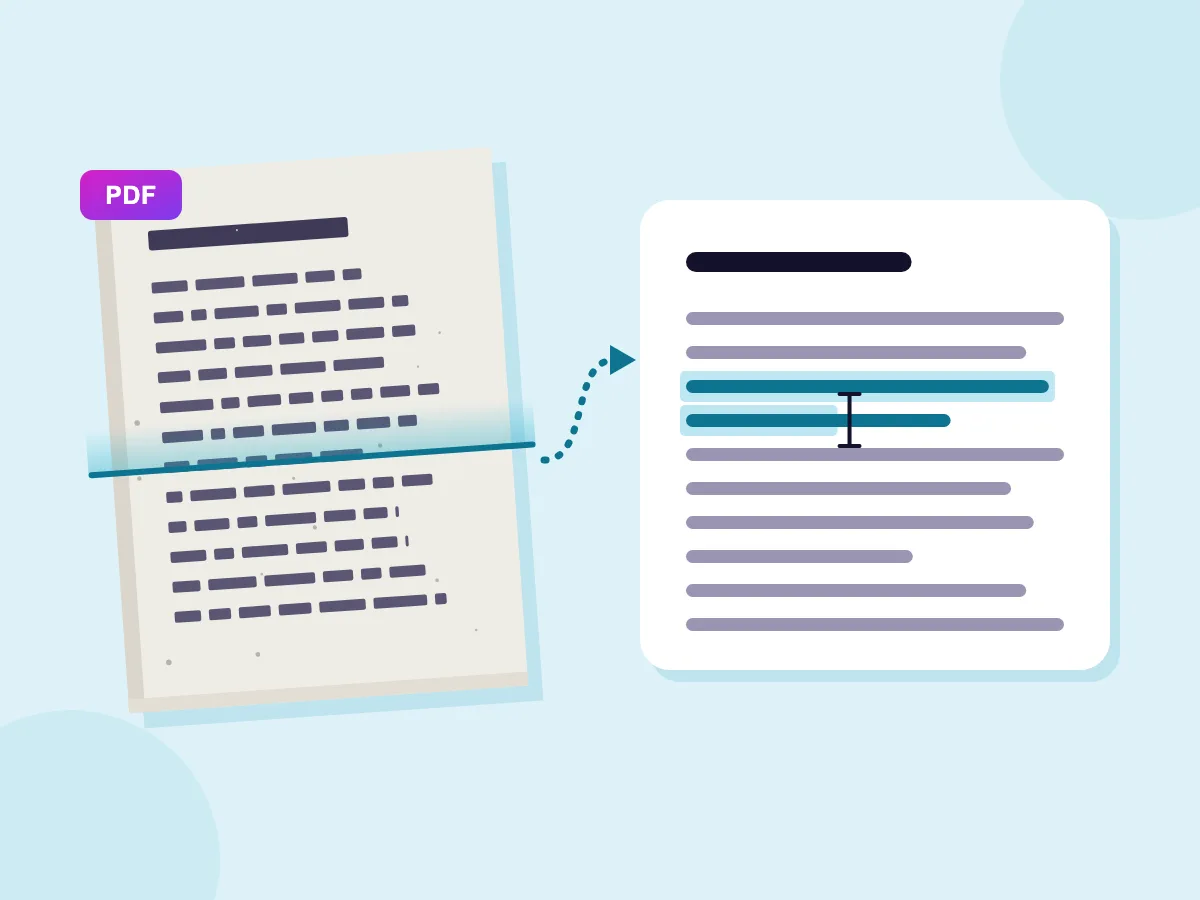
支持扫描页面(OCR)
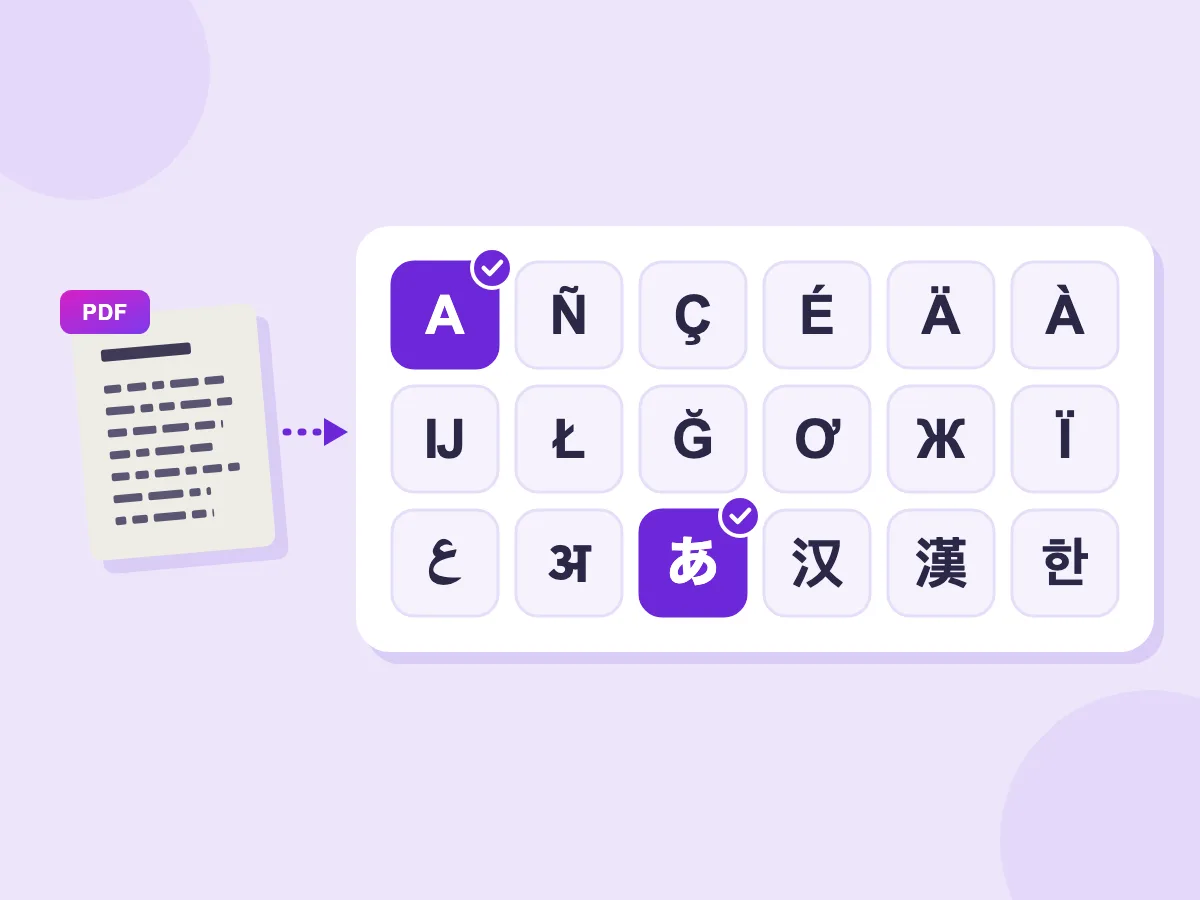
18种OCR识别语言
- 段落整理
- 最多20个PDF同时处理
- 复制或保存为.txt
PDF转文字的常见用途
办公场景
- 从合同或扫描信件中复制条款
- 重复利用保存为PDF的报告或幻灯片中的文字
- 获取发票或银行对账单中的详细信息
- 将文字粘贴到文档或表格应用中进行编辑
学习与研究
- 引用论文内容,无需重新输入
- 将扫描的书页转换为可搜索的笔记
- 提取讲座幻灯片和讲义中的文字
- 一次性从多个PDF中收集引用内容
日常使用
- 将PDF粘贴到AI聊天工具中进行总结或提问
- 复制无法选中文字的PDF内容
- 将文字粘贴到翻译工具中
- 将手册、表单或食谱保存为纯文本文件
为什么有些PDF无法复制文字?
有些PDF存储的是文字的图片,而不是真正的文字。扫描页面本质上只是一张图片,所以没有内容可以选中或复制。这个转换器会直接读取PDF中真实存在的文字,无需OCR,速度快且精确无误。只有遇到图片形式的页面时,才会启动OCR识别。
使用OCR将扫描版PDF转换为文字
扫描版PDF本质上是每页内容的图片,因此需要通过OCR(光学字符识别)来读取文字。这个转换器会自动检查每一页,并对扫描页面自动进行OCR识别。
- 每一页都会被标记为文字、OCR或空白,方便你了解哪些页面是扫描件。
- 如果某页文字复制出来是方框或乱码,也会被识别为扫描件并进行OCR处理。
- 扫描页面会按照你选择的语言进行识别。可从18种语言中选择,最多同时选择3种。
- 如果某页文字看起来不对,点击对应页码,选择「用OCR识别」重新按扫描件处理。
混合类型的PDF同样支持。打印文字页面与扫描页面会按页面顺序合并为一份完整文字。
如果是照片或截图而不是PDF?可通过图片转文字工具提取文字。
去除PDF文字中的换行符复制
从PDF中复制的文字通常每行末尾都会自动换行。「合并换行为段落」功能会将折行的句子重新拼接起来,方便粘贴到文档、邮件或AI聊天工具中。此功能默认开启。
整理功能还会修复其他导致PDF文字混乱的问题:
- 行末因连字符断开的单词会被重新拼接为完整单词。
- 标题、列表项和表格行会保持在独立的行中。
- 「去除页眉页脚和页码」会删除各页面重复出现的页眉、页脚和页码,此功能默认开启。
- 类似「--- 第3页 ---」的页面标记会显示每页的起始位置。关闭此选项可获得一整段连续文字。
每个选项都会立即更新文字,无需重新读取PDF。关闭「合并换行为段落」可保留PDF原有的所有换行方式。
免费、私密、无限制使用
这款PDF转文字工具完全免费,无需注册,无需账户。此外还有:
- 隐私保护。你的PDF全程保存在本地设备上,直接在手机或电脑上打开并读取,文件绝不会上传到服务器。
- 无页数限制,无每日限制。每个PDF最大支持100 MB,单次最多可添加20个文件。
- 加密文件也可安全处理。带密码保护的PDF会在你的设备上用你输入的密码打开,密码本身不会被保存。
首次识别扫描页面时,OCR识别模块会下载一次(英文约4 MB),并保存在浏览器中,之后识别速度会更快。仅含真实文字的PDF不需要下载此模块。
从PDF中提取文字的最佳方法是什么?
先读取PDF中已有的文字,再对扫描页面用正确的语言进行OCR识别。这样能保证打印文字页面完全准确,扫描页面也尽可能精确。这个工具会逐页自动为你做出最佳选择。
以下技巧可以帮助你获得更干净的文字:
- 选择正确的OCR语言。例如,德语文本如果按英语识别,会丢失变元音等特殊字符。
- 如果扫描内容混合多种语言,可最多选择3种语言。
- 使用清晰、端正的扫描件。模糊或倾斜的页面会产生更多识别错误。
- 如果某页识别结果乱码,点击对应页码,选择「用OCR识别」。
- 仔细检查扫描页面中的姓名、数字和邮箱地址,这些内容最容易被识别错误。
PDF的OCR识别需要多长时间?包含真实文字的页面几乎瞬间完成读取,即使PDF很长也是如此。每个扫描页面需要几秒钟,你可以随时查看进度或停止处理。
OCR主要针对印刷文字设计。手写文字和质量较差的扫描件通常会出现较多识别错误。复杂排版(如杂志和表单)也可能导致文字顺序混乱,建议使用前仔细检查文字内容。
常见问题
扫描页面、语言、限制与隐私
如何免费将PDF转换为文字?
将PDF添加到本页顶部的框中,每页读取完成后文字会自动显示。然后可以复制文字或下载为.txt文件。完全免费,无需注册,无每日限制。
可以从扫描版PDF中提取文字吗?
可以。没有真实文字的页面会被自动检测出来,并按你选择的语言进行OCR识别。清晰的印刷扫描件识别效果最好。模糊的复印件和手写文字容易产生更多错误,请注意核对姓名和数字。
我的PDF会上传到服务器吗?
不会。你的PDF会在你自己的设备上打开并读取,文件及提取的文字都保存在本地。首次识别扫描页面时,工具会下载一个OCR语言模型,但PDF本身的任何内容都不会被发送出去。
可以从带密码保护的PDF中提取文字吗?
可以,前提是你知道密码。系统会提示你输入密码,PDF随后在你的设备上打开。此工具不会破解或移除密码,你的密码也不会被保存或发送到任何地方。
支持哪些语言识别?
包含真实文字的页面会按PDF本身存储的语言读取。扫描页面则使用OCR技术,支持18种语言识别,包括英语、西班牙语、法语、德语、中文、日语、韩语、阿拉伯语、印地语和俄语。混合文字最多可同时选择3种语言。
转换后会保留原有排版格式吗?
不会。转换结果为纯文本,因此字体、颜色、图片和精确排版都不会保留。但标题、列表项和表格行仍会各自保持独立的行。如果想完全保留页面原始外观,可以改用将页面转换为图片。
可以将文字保存为TXT文件吗?
可以。「下载.txt」会生成一个以PDF文件名命名的UTF-8文本文件,确保带重音符号或非拉丁字母的文字能正常显示。你可以先编辑文字,保存的将是编辑后的内容。
有页数或文件大小限制吗?
没有页数限制,也没有每日限制。每个PDF最大支持100 MB,单次最多可添加20个PDF文件。较长的扫描版PDF处理时间会更长,因为每个扫描页面都是逐一识别的。
可以同时转换多个PDF吗?
可以,最多同时处理20个PDF,系统会依次读取。之后可以复制全部文字,下载为带各PDF标题的单个.txt文件,或获取每个PDF对应一个文本文件的ZIP包。
可以在手机上使用吗?
可以。在iPhone或安卓手机浏览器中打开本页,添加PDF即可复制文字,无需安装任何应用。手机上处理扫描页面的速度会比电脑慢一些。